Podpis „Źródło: Google Analytics” nie wystarczy, żeby obronić wynik przedstawiony w case study. Nie wyjaśnia, który raport wykorzystano, jakie okresy porównano ani czy po drodze zmieniono sposób liczenia konwersji. Podobnie działa dopisek „opracowanie własne” pod wykresem. Informuje, kto przygotował materiał, ale nie pozwala sprawdzić obliczeń.
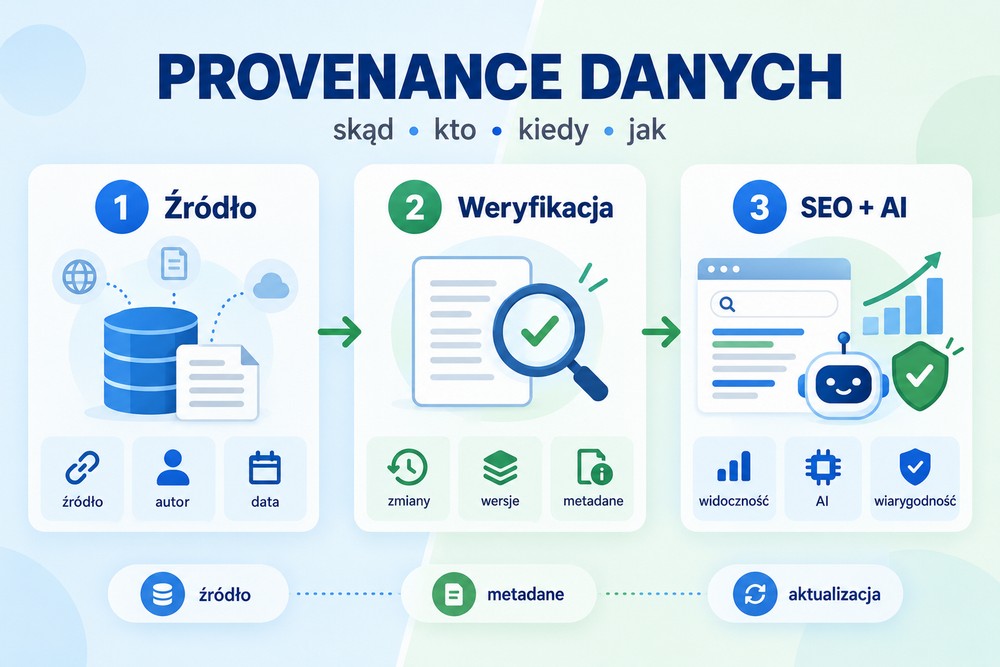
Provenance danych wypełnia tę lukę. Łączy opublikowaną informację z jej pochodzeniem, historią przetwarzania i odpowiedzialnością za wynik. Właścicielowi strony daje coś znacznie bardziej użytecznego niż ogólna deklaracja wiarygodności: możliwość ustalenia, skąd wzięła się konkretna liczba, kto ją przygotował, kiedy została zebrana, jak ją zmieniono oraz co trzeba sprawdzić, gdy ktoś zakwestionuje jej poprawność.
Provenance danych: więcej niż wskazanie źródła
Provenance danych to udokumentowane pochodzenie i historia danych: skąd się wzięły, kto je dostarczył, kiedy zostały zebrane, jak je przekształcono oraz czy, kiedy i przez kogo zostały zweryfikowane.
Nie jest to pojęcie stworzone na potrzeby SEO ani generatywnej AI. W praktyce internetowej nabiera jednak szczególnego znaczenia, bo strony coraz częściej publikują dane pochodzące z wielu miejsc: analityki internetowej, systemów CRM, raportów branżowych, badań ankietowych, API, arkuszy kalkulacyjnych, narzędzi SEO i modeli AI.
Na stronie internetowej obiektem wymagającym opisania provenance może być:
- wynik przedstawiony w case study,
- średnia cena usługi,
- wykres zmian ruchu organicznego,
- statystyka dotycząca rynku,
- ranking produktów lub usług,
- wynik własnego testu,
- tabela porównawcza,
- wartość pobrana z zewnętrznego API,
- dane wygenerowane lub przetworzone przy użyciu AI.
Różnicę między zwykłym źródłem a provenance najłatwiej pokazać na przykładzie.
„Źródło: badanie własne” mówi niewiele. Nie wiadomo, kiedy badanie wykonano, ilu uczestników wzięło w nim udział, jak dobrano próbę ani jak policzono wynik.
Znacznie lepszy opis wygląda tak:
Badanie przeprowadzono w sierpniu 2026 roku na grupie 312 klientów sklepów internetowych z Polski. Odrzucono 17 niekompletnych ankiet. Wynik obliczono na podstawie 295 pełnych odpowiedzi.
Druga wersja pozwala ocenić, czego właściwie dotyczy liczba i jak powstała. To właśnie jest praktyczna wartość provenance.
Źródło jest początkiem historii danych, a nie całą historią.
Trzeba też rozdzielić role poszczególnych osób i organizacji. Autor tekstu nie musi być twórcą danych. Osoba przygotowująca wykres nie musi odpowiadać za pomiar. Producent przekazujący specyfikację produktu nie staje się niezależnym weryfikatorem własnych parametrów.
Dlatego w artykułach warto stosować precyzyjne oznaczenia:
- dane producenta — jeśli informacja pochodzi bezpośrednio od producenta,
- pomiar własny — jeśli redakcja faktycznie wykonała test,
- obliczenia własne na podstawie danych… — jeśli wykorzystano cudzy zbiór, ale samodzielnie wykonano przeliczenie,
- dane z systemu analitycznego — jeśli wynik pochodzi np. z GA4, Search Console lub CRM,
- szacunek — jeśli liczba nie jest wynikiem bezpośredniego pomiaru.
Nie należy podpisywać przeliczonej tabeli jako „badania własnego”, jeśli materiał wejściowy pochodzi z raportu GUS, Eurostatu, raportu branżowego albo bazy innej firmy.
Przy danych publicznych dobrym przykładem jest Bank Danych Lokalnych GUS. Sam zapis „Źródło: GUS” bywa zbyt ogólny. Jeżeli na podstawie danych ma powstać analiza, wewnętrznie warto zapisać również:
- nazwę konkretnego wskaźnika,
- rok lub okres danych,
- jednostkę terytorialną,
- jednostkę miary,
- datę pobrania danych,
- wykonane przeliczenia.
Provenance nie jest jednak certyfikatem prawdziwości. Można bardzo dokładnie opisać źle wykonane badanie. Można również poprawnie przepisać wynik raportu, którego metodologia nie pasuje do tezy artykułu.
Jeżeli ankietę przeprowadzono wśród 300 klientów jednej firmy, nie należy wyciągać z niej wniosku o wszystkich polskich przedsiębiorcach. Dobre provenance pomaga zauważyć takie ograniczenie, ale samo go nie usuwa.
Znaczenie provenance w SEO, GEO i odpowiedziach AI
W SEO provenance nie działa jak przełącznik typu „dodaj źródło i zyskaj pozycje”. Nie istnieje również pojedynczy znacznik HTML, którego wdrożenie automatycznie zwiększa widoczność strony.
Znaczenie provenance jest bardziej praktyczne. Pomaga stworzyć treść, w której konkretne twierdzenia można zweryfikować, a autor, redakcja i właściciel strony wiedzą, skąd pochodzą publikowane dane.
Jeżeli artykuł podaje średni koszt usługi, sama kwota nie wystarcza. Czytelnik powinien wiedzieć przynajmniej:
- jakiego zakresu usługi dotyczy cena,
- czy podano kwotę netto czy brutto,
- z jakiego okresu pochodzą ceny,
- ile ofert uwzględniono,
- czy podano średnią, medianę czy przedział cenowy.
Przykład: informacja „pozycjonowanie sklepu kosztuje średnio 3000 zł miesięcznie” jest praktycznie bezużyteczna bez dodatkowego kontekstu. Inaczej wygląda oferta dla sklepu z 200 produktami, inaczej dla serwisu z 100 tys. adresów URL i sprzedażą na kilku rynkach.
W przypadku GEO, czyli optymalizacji treści pod systemy generatywne i odpowiedzi AI, provenance staje się jeszcze ciekawsze. System analizujący stronę potrzebuje możliwie jednoznacznego kontekstu. Liczba wyrwana z otoczenia może zostać źle zinterpretowana, nawet jeśli sama w sobie jest poprawna.
Dlatego przy ważnych danych dobrze umieszczać blisko siebie:
- sam wynik,
- okres, którego dotyczy,
- definicję mierzonego wskaźnika,
- źródło,
- najważniejsze ograniczenie.
Zamiast pisać:
„Konwersja wzrosła o 40%.”
lepiej napisać:
„Liczba zamówień z ruchu organicznego wzrosła z 500 do 700 miesięcznie, czyli o 40%, między czerwcem a sierpniem 2026 roku. Dane pochodzą z systemu analitycznego sklepu.”
To drobna różnica stylistyczna, ale duża różnica informacyjna.
Nie należy jednak obiecywać, że taki zapis zagwarantuje cytowanie strony przez ChatGPT, Google AI Overviews, Gemini, Perplexity albo inny system. Provenance poprawia warunki do prawidłowej interpretacji informacji, ale nie daje gwarancji wykorzystania jej przez AI.
Podobnie jest z SEO. Dobrze udokumentowana treść może zwiększać jej wiarygodność i ułatwiać użytkownikowi ocenę informacji, ale nie istnieje prosty wzór typu:
więcej źródeł = wyższa pozycja.
W praktyce ważniejsza jest jakość powiązania źródła z konkretnym twierdzeniem niż długość bibliografii.
Osobny temat stanowią treści tworzone lub przetwarzane przy użyciu AI. Jeżeli model:
- klasyfikuje odpowiedzi ankietowe,
- wyciąga liczby z dokumentów,
- porządkuje dane,
- łączy kilka zbiorów,
- wykonuje analizę jakościową,
warto zachować informację o tym, jakie dane wejściowe otrzymał, do czego został wykorzystany oraz jak zweryfikowano rezultat.
Nazwa modelu AI nie jest źródłem danych. Jeżeli statystyka pochodzi z raportu Eurostatu, to Eurostat jest źródłem danych. Model AI może być narzędziem użytym do ich przetworzenia lub podsumowania.
To rozróżnienie jest szczególnie ważne w tekstach eksperckich. Informacja „według AI 62% firm…” nie ma wartości, jeśli AI nie wykonało własnego badania i nie istnieje możliwe do wskazania źródło tej liczby.
Provenance pomaga również uniknąć jednego z częstszych problemów redakcyjnych: cytowania liczby po kilku kolejnych przepisaniach. Raport A publikuje dane. Portal B je streszcza. Blog C cytuje portal B. Następnie kolejny tekst powołuje się na blog C, a po kilku latach nikt już nie pamięta, skąd liczba faktycznie pochodziła.
Jeżeli można dotrzeć do pierwotnego źródła, właśnie ono powinno być podstawą weryfikacji.
Jak wdrożyć provenance danych na stronie
Nie zaczynałbym od instalowania kolejnej wtyczki do WordPressa. Najpierw trzeba ustalić, które dane na stronie rzeczywiście wymagają kontroli pochodzenia.
Najwyższy priorytet mają:
- case studies,
- raporty,
- rankingi,
- porównania,
- statystyki wykorzystywane w sprzedaży,
- informacje o cenach,
- treści finansowe, prawne i medyczne,
- liczby wykorzystywane jako dowód skuteczności usługi.
Na początek można wybrać 10 najważniejszych podstron i sprawdzić wszystkie istotne liczby. Dla każdej z nich trzeba odpowiedzieć na kilka prostych pytań.
- Skąd pochodzi ta liczba?
- Kiedy zebrano dane?
- Kto odpowiada za źródło?
- Jak dane zostały przeliczone?
- Czy ktoś zweryfikował wynik?
- Czy liczba jest nadal aktualna?
Jeżeli na któreś z tych pytań nie da się odpowiedzieć, mamy problem z provenance.
Najprostszy rejestr danych można prowadzić w arkuszu. Nie potrzeba na początku zaawansowanego systemu data governance. Ważniejsze jest konsekwentne zapisywanie tych samych informacji.
Dla każdego istotnego wskaźnika warto przechowywać:
- źródło — raport, narzędzie, API, badanie, baza danych,
- dostawcę danych — np. GUS, klient, producent, własny system analityczny,
- okres danych — konkretny miesiąc, kwartał, rok lub zakres dat,
- datę pobrania,
- metodę obliczenia,
- zastosowane filtry,
- wykluczenia,
- wersję danych,
- osobę odpowiedzialną,
- datę ostatniej kontroli.
W przypadku większego serwisu rekord powinien dotyczyć konkretnej liczby, tabeli lub zbioru danych, a nie całego artykułu. Jeden tekst może zawierać dane pochodzące z pięciu niezależnych źródeł.
Nie wszystko trzeba publikować użytkownikowi. Warstwa publiczna powinna być krótka, a dokumentacja wewnętrzna dokładna.
Na stronie może wystarczyć zapis:
Dane: Google Search Console, Polska, wszystkie urządzenia, porównanie lipiec–sierpień 2026. Eksport: 4 września 2026.
W wewnętrznym rejestrze można dodatkowo zachować nazwę usługi, zastosowane filtry, eksport CSV, sposób wykonania obliczenia oraz osobę zatwierdzającą wynik.
Przykładowa metryka może wyglądać następująco:
Wynik: wzrost liczby kliknięć z 12 000 do 16 800, czyli o 40%.
Źródło: Google Search Console.
Zakres: Polska, wszystkie urządzenia, wyszukiwanie internetowe.
Porównanie: 1–31 lipca i 1–31 sierpnia 2026 roku.
Obliczenie: (16 800 − 12 000) / 12 000 × 100% = 40%.
Data eksportu: 4 września 2026 roku.
Ograniczenie: wynik opisuje kliknięcia z wyszukiwarki, a nie sprzedaż i nie dowodzi samodzielnie, że wzrost spowodowała jedna konkretna zmiana SEO.
To ostatnie zdanie jest szczególnie ważne. W SEO często myli się korelację z przyczynowością. Jeżeli po zmianie treści ruch wzrósł o 40%, nie oznacza to jeszcze, że całość wzrostu spowodowała ta zmiana. W tym samym czasie mogła zmienić się sezonowość, popyt, widoczność konkurencji, struktura SERP albo inne elementy serwisu.
Trzeba również uważać na różnice między interfejsem narzędzia a eksportowanymi danymi. W systemach analitycznych suma widocznych wierszy nie zawsze musi odpowiadać wartości prezentowanej w innym miejscu raportu. Filtry, anonimizacja danych, próbkowanie, definicje zdarzeń lub późniejsze przetwarzanie potrafią zmienić wynik.
Dlatego zapis „dane z Search Console” albo „dane z GA4” jest za mało precyzyjny przy istotnym case study.
Kolejny etap to dane strukturalne i metadane. W przypadku artykułu można prawidłowo opisać autora, datę publikacji i datę modyfikacji. Jeśli strona rzeczywiście publikuje zbiór danych, można rozważyć odpowiedni typ danych strukturalnych dla datasetu.
Nie należy jednak dodawać znaczników tylko dlatego, że technicznie są dostępne. Dane strukturalne powinny odpowiadać realnej zawartości strony. Zwykły wpis blogowy zawierający trzy statystyki nie staje się automatycznie zbiorem danych.
Podobnie nie należy dopisywać w kodzie informacji o ekspercie, badaniu, autorze lub metodologii, których użytkownik nie może znaleźć w widocznej treści.
Oddziel też datę danych od daty aktualizacji artykułu.
To cztery różne rzeczy:
- data wykonania pomiaru,
- data pobrania danych,
- data ich weryfikacji,
- data modyfikacji artykułu.
Jeżeli raport pochodzi z marca, a tekst sprawdzono ponownie we wrześniu, dane nadal są marcowe. Zmiana daty artykułu nie odmładza danych.
Dobry proces aktualizacji powinien uruchamiać się wtedy, gdy:
- pojawia się nowa edycja raportu,
- zmienia się cennik,
- źródło publikuje korektę,
- zmienia się metodologia pomiaru,
- zmienia się definicja wskaźnika,
- publikowana wartość przestaje odpowiadać aktualnej sytuacji.
Najbardziej irytujący problem pojawia się w serwisach częściowo zautomatyzowanych. Tabela pobiera nową wartość z API, ale tekst nad nią nadal opisuje starą liczbę. Data aktualizacji zmienia się automatycznie, mimo że nikt nie sprawdził wniosku. W efekcie technicznie „świeża” strona zawiera niespójne informacje.
Jeżeli dane są aktualizowane automatycznie, najlepiej korzystać z jednego zatwierdzonego źródła rekordu, z którego korzystają wszystkie elementy strony.
Trzeba również ustalić granicę transparentności. Provenance nie oznacza publikowania plików zawierających dane klientów, identyfikatory użytkowników czy informacje poufne.
W realiach polskich i europejskich dochodzą obowiązki wynikające z RODO. Dokumentacja pochodzenia danych powinna pomagać ustalić, skąd informacja pochodzi i kto jej używa, ale nie zwalnia z zasad minimalizacji danych, ograniczenia dostępu i odpowiedniego zabezpieczenia informacji.
Publicznie pokazuj więc tyle, ile potrzebuje czytelnik do oceny wiarygodności wyniku. Szczegółowe eksporty, dane osobowe, identyfikatory klientów i materiały operacyjne powinny pozostać w kontrolowanym środowisku.
Najważniejsza rzecz na koniec nie jest techniczna. Każdy istotny zbiór danych powinien mieć właściciela. Kogoś, kto odpowiada za jego aktualność i wie, co zrobić po korekcie źródła.
Jeżeli masz zacząć od jednego działania, wybierz najważniejsze case study na stronie i spróbuj odtworzyć jego główny wynik od początku do końca. Sprawdź źródło, okres, filtry i obliczenie. Jeśli wyniku nie da się powtórzyć, popraw go albo usuń. Dopiero później zajmuj się rozbudowanymi metadanymi i automatyzacją.
FAQ — provenance danych na stronie internetowej
Czy samo podanie źródła pod artykułem wystarczy?
Nie, jeśli tekst zawiera przeliczenia, porównania lub własne wnioski. Przy ważnych danych trzeba znać również okres, metodę, zakres oraz istotne przekształcenia.
Czy provenance danych poprawia SEO?
Nie istnieje gwarancja wzrostu pozycji po dodaniu informacji o pochodzeniu danych. Dobrze opisane źródła zwiększają jednak przejrzystość treści i ułatwiają ocenę konkretnych twierdzeń przez użytkownika.
Czy provenance zwiększa szansę na cytowanie przez AI?
Może ułatwiać prawidłową interpretację danych, ponieważ wynik ma jasno opisany kontekst. Nie gwarantuje jednak wykorzystania strony przez ChatGPT, Google AI Overviews, Gemini ani inne systemy.
Czy do wdrożenia provenance potrzebna jest specjalna wtyczka WordPress?
Nie. Na początku wystarczy uporządkowany rejestr danych, odpowiednie pola w CMS i krótka metryka publikowana przy istotnych wynikach. Narzędzia automatyzujące mają sens dopiero przy większej skali.
Co zapisywać, gdy przy analizie danych korzystam z AI?
Zapisz materiał wejściowy, narzędzie wykorzystane do przetwarzania, zakres zadania, datę oraz sposób sprawdzenia wyniku. AI traktuj jako narzędzie przetwarzające, a nie automatycznie jako pierwotne źródło informacji.
Jak często aktualizować dane w artykule?
Nie ma jednego terminu dla wszystkich treści. Ceny mogą wymagać kontroli co kilka miesięcy, dane rynkowe po publikacji kolejnego raportu, a stabilne dane historyczne znacznie rzadziej. Harmonogram powinien wynikać z tempa zmian konkretnego źródła.
Od czego zacząć na istniejącej stronie?
Od najważniejszego wyniku używanego w sprzedaży, case study lub poradniku. Odtwórz jego źródło, okres, filtry i sposób obliczenia. Jeśli nie można tego zrobić, najpierw popraw samą informację. Dopiero później rozbudowuj metadane.